H20으로 LLM을 서빙해보려 한다. 벤치마크에 앞서 어떤 GPU인지, 실제로 어디에 쓰이고 있는지부터 찾아봤다.
카드 스펙부터 찾아보자
H20은 중국 시장을 위해 설계된 NVIDIA의 Hopper 계열 GPU다. NVIDIA도 실적 자료에서 H20의 주된 대상 시장이 중국이라고 설명한다. NVIDIA CFO 자료
자료를 찾는 과정은 H100·H200과 조금 달랐다. 두 제품은 공식 페이지에서 사양과 데이터시트로 바로 이어진다. H20은 이번 조사에서 그에 해당하는 공개 제품 페이지를 찾지 못했다. 대신 NVIDIA의 지원 문서와 실제 운영팀의 기술 글을 함께 봐야 했다.
아래는 확인한 메모리 사양이다. H20의 4.0 TB/s는 NVIDIA 데이터시트가 아니라 Ant 운영팀이 공개한 96GB 모델의 수치다.
| GPU | 메모리 용량 | 메모리 대역폭 |
|---|---|---|
| H100 SXM | 80GB | 3.35 TB/s |
| H200 SXM | 141GB | 4.8 TB/s |
| H20 96GB | 96GB | 4.0 TB/s¹ |
| H20 141GB / H20-3e | 141GB | 이번 조사에서 확인하지 못함 |
출처: NVIDIA H100 사양·데이터시트, H200 사양·데이터시트, H20 공식 지원 문서, ¹Ant의 H20-96G 비교표.
Ant의 비교표에서 H20-96G의 BF16 연산 성능은 148 TFLOPS로, 비교 대상인 H800의 989 TFLOPS보다 훨씬 낮다. 반면 메모리 용량과 대역폭은 더 크다. 연산 성능이 줄었다고 해서 모든 사양이 같은 비율로 줄어든 GPU는 아니다.
H20 96GB와 H20-3e 141GB
H20을 검색하면 96GB가 주로 보이지만, 141GB 모델도 있다. NVIDIA AI Enterprise 문서는 H20 SXM5 96GB와 H20 SXM5 141GB를 별도로 나열한다. NVIDIA 공식 문서
GitHub에서는 141GB 모델을 H20-3e라고 부르는 기록을 찾을 수 있다. vLLM의 PR #19205는 이 이름을 명시하고, 해당 GPU를 위한 DeepSeek MoE 튜닝 설정을 추가한다. vLLM PR #19205
이 연재에서 직접 다룰 장비는 H20-3e다. 96GB보다 메모리가 45GB 더 크다. 모델 가중치를 올린 뒤 KV cache에 쓸 공간도 달라질 수 있다. 이후 사용 사례를 읽을 때도 어느 모델인지 구분하려 한다. 96GB 모델의 연산량과 대역폭을 141GB 모델에 그대로 옮겨 적지는 않았다.
Ant와 Alibaba는 어떻게 쓰고 있을까
Ant: Prefill과 decode를 분리한 구성
Ant는 2025년 9월, H20 96GB에서 DeepSeek-R1을 운영한 구성을 공개했다. 입력을 처리하는 prefill은 GPU 8장을 한 노드에 묶는 TP8, 토큰을 생성하는 decode는 두 노드·16장에 전문가를 나누는 EP16을 사용했다. Ant·SGLang 기술 글
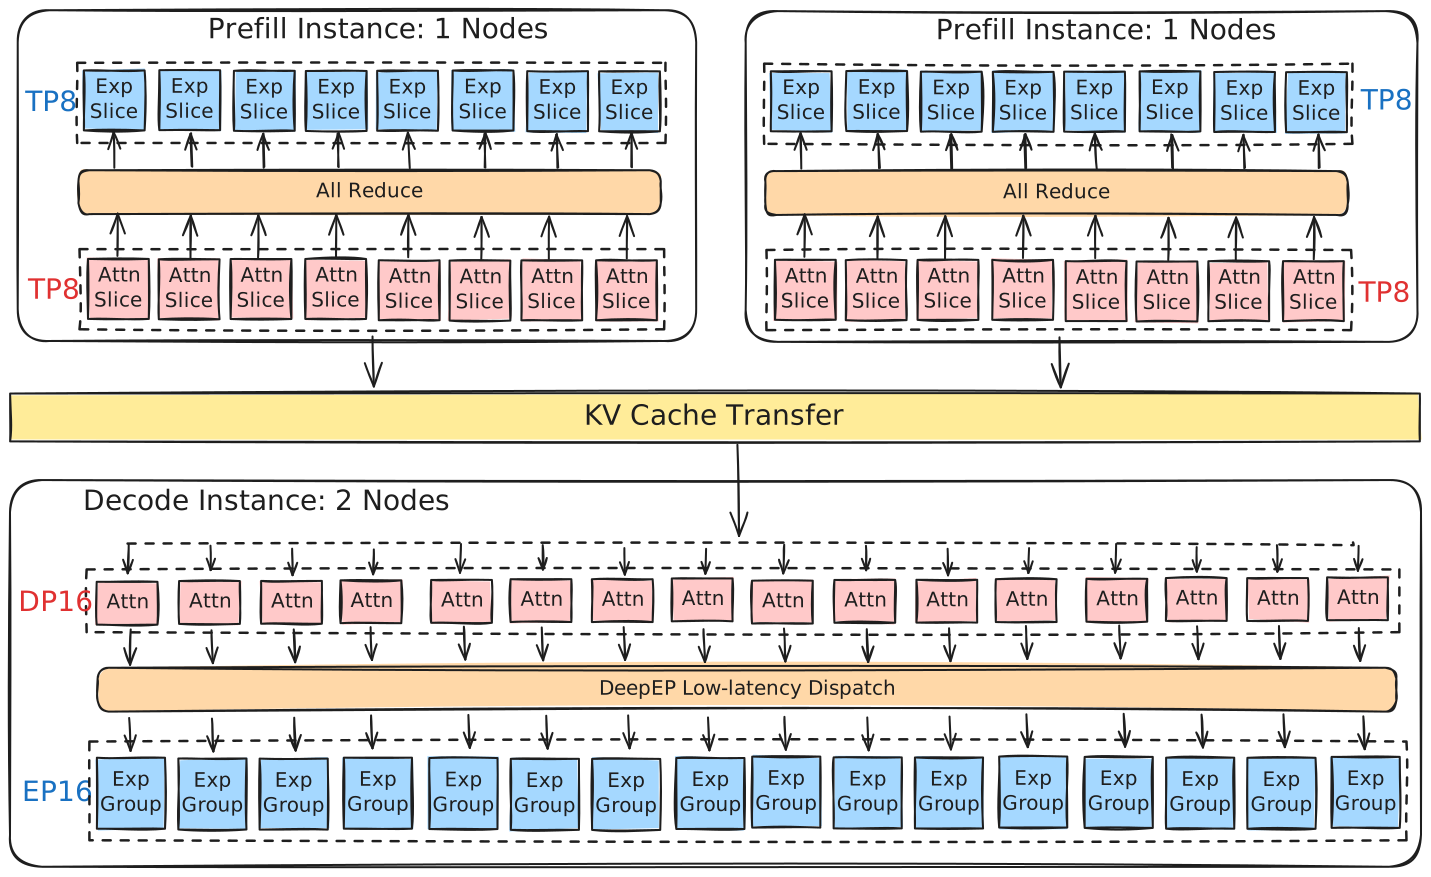
Ant가 공개한 배포 구성도. 위는 prefill, 아래는 decode다. 원문 도식.
실제 온라인 서비스도 지연 목표에 따라 나눴다. 예를 들어 InferX Max는 첫 토큰까지 1초 미만, 이후 토큰당 30ms 미만을 목표로 한다. 이를 맞추기 위해 배치 크기와 추측 디코딩 설정을 조절했다. 같은 H20에서도 처리량을 우선할지, 응답 속도를 우선할지에 따라 운영 설정이 달라진다.
Alibaba: 여러 모델이 공유하는 GPU
Alibaba의 Aegaeon은 요청이 드문 모델마다 GPU를 계속 배정하는 낭비를 줄이는 시스템이다. 요청 전체가 끝날 때까지 기다리지 않고, 토큰 생성 중에도 모델에 할당한 자원을 바꾼다.
SOSP 2025 논문은 Model Studio에서 3개월 넘게 베타 운영한 결과를 담고 있다. 1.8B부터 72B까지 47개 모델을 서빙하는 데 쓰던 H20을 1,192장에서 213장으로 줄였다고 보고한다. 이는 GPU 자체의 성능 향상이 아니라, 여러 모델이 자원을 공유하도록 바꾼 운영 사례다. 해당 운영 단락은 H20의 메모리 변형을 명시하지 않는다. Aegaeon 논문 §7.5
두 사례에서 보고 싶었던 것은 최고 속도보다 실제 배치 방식이었다. Ant는 응답 단계별로 GPU 구성을 달리했고, Alibaba는 모델별로 묶여 있던 GPU를 공유했다.
GitHub에서 찾은 최적화 흔적
운영 사례에서 한 단계 더 들어가면, H20에 맞춰 코드를 고친 흔적이 보인다.
GitHub · vllm-project / vllm · #19205 ↗ Add H20-3e fused MoE kernel tuning configs for DeepSeek-R1/V3 “H20-3e is H20 GPU with 141G memory.” Merged · 2025-06-05 UTCvLLM PR #19205 · 원문 제목과 설명 발췌. H20-3e용 튜닝 설정을 추가한 변경.
vLLM은 H20-3e용 MoE 설정을 추가했다. 앞서 본 PR #19205에는 H20-3e 8장으로 DeepSeek-R1-0528을 서빙한 결과가 있다. 기여자가 보고한 출력 처리량은 튜닝 전 194.15 tok/s, 이후 225.04 tok/s다. 같은 장비에서 설정을 바꾼 비교이며, PR은 2025년 6월 5일(UTC) 병합됐다. 벤치마크와 실행 명령
H20용 최적화가 다른 Hopper GPU에 그대로 맞는 것도 아니다. SGLang PR #8722는 H20에서 쓰던 FP8 행렬 연산을 H100·H200·H800에 옮겼을 때 성능이 떨어진 문제를 다룬다. 연산 단계별 소요 시간의 비중이 달라져, 이 GPU들에는 다른 스케줄을 적용했다. 2025년 8월 3일(UTC) 병합된 변경이다. SGLang PR #8722
하나는 모델 전체의 서빙 결과이고, 다른 하나는 특정 커널의 동작이다. 범위는 다르지만, H20이 실제 최적화 대상으로 다뤄지고 있다는 점은 확인할 수 있다.
이제 직접 돌려보자
사례를 찾았으니 작은 조건부터 확인해봤다. Qwen3-32B를 BF16으로 GPU 한 장에 올리고, 입력·출력을 각각 512토큰, 동시 요청을 1개로 맞췄다. H100·H200은 같은 프로토콜의 Jarvislabs 공개 결과를 사용했다.
| GPU | 첫 토큰까지, TTFT p50 | 출력 처리량 |
|---|---|---|
| H20-3e | 260.7ms | 49.7 tok/s |
| H100 SXM | 58.5ms | 40.1 tok/s |
| H200 SXM | 56.3ms | 53.6 tok/s |
H20-3e는 자체 실험 집계값, H100·H200은 공개 측정값. 호스트 환경은 다르다.
H20-3e의 첫 토큰은 H100보다 약 202ms 늦었다. 그런데 출력 처리량은 약 24% 높았다. 첫 토큰 이후의 토큰당 시간(TPOT)도 19.65ms로, H100의 24.88ms보다 짧았다.
입력을 처리하는 prefill과 토큰을 이어 만드는 decode에서 서로 다른 특성이 보인다. 작은 배치의 decode는 메모리 대역폭의 영향을 많이 받을 수 있다. 이번 결과도 그 설명과 맞지만, 병목을 프로파일링으로 확인한 것은 아니다. TTFT에는 prefill 외의 지연이, 출력 처리량에는 입력 처리 시간도 포함된다.
다음 편에서는 입력을 512토큰에서 8,192토큰으로 늘려본다. 첫 토큰을 기다리는 시간이 얼마나 달라지는지, 짧은 입력에서 보인 처리량의 이점이 남는지 살펴보겠다.
측정 메모: vLLM 0.29.0, Qwen3-32B BF16 가중치·KV cache, TP1, 조건별 32요청 × 3회. H20-3e는 제공된 자료 묶음 B2의 p50 집계값이며 개별 실행 JSON을 재집계하지 않았다. H100·H200은 고정 커밋의 원본 JSON에서 실행별 p50의 중앙값과 처리량 중앙값을 확인했다. 품질·비용은 측정하지 않았다. 상세 비교 프로토콜